有个同学非常得意地告诉我,他论文里引了一大段知乎高赞回答,反正网上的东西,系统查不到吧?两周后他拿着报告来找我,那段话整段飘红,来源标注是“互联网资源库”。他懵了:网上的东西也算?
算。这就是很多人对查重系统数据库最大的误会。互联网资源库不是摆设,它是各家系统都会抓的一块。系统会定期抓取公开可访问的网页内容——新闻门户、百科词条、论坛问答、博客、公众号文章,部分系统还会收录百度文库、道客巴巴这类文档分享站。你在知乎看到一段顺手抄进论文,等于抄进了一个已经被抓取入库的网页。
那知乎、B站、公众号到底收不收?要分情况。文字类的公开内容,比如知乎回答、公众号文章、网页正文,被抓取比对的概率很高。B站、短视频平台里,能被文字转写出来的台词、字幕,部分系统也在覆盖。但请注意:抓取是主动去抓公开页,不是全站实时同步。这意味着你今天新发的一条动态,系统库里未必马上有;但三个月前的老帖子,大概率早就被收进去了。
更隐蔽的是文档分享站。很多同学图省事,直接从百度文库下一篇综述改写。问题在于,文库里的稿子本身可能也是别人抄来抄去的二手货,多层叠加之后,你以为是新内容,系统库早有记录。我见过重复来源层层指向同一个文库文档的案例,改都不知道从何改起。
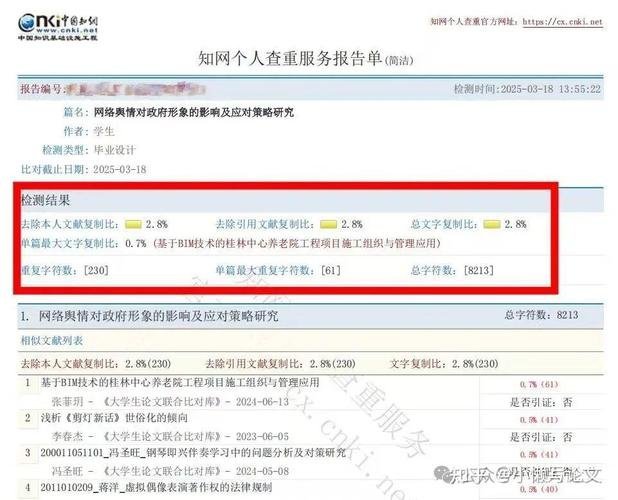
给你三条避坑建议:其一,凡是从网上直接复制的段落,不管它来自多冷门的角落,都当作必被查来对待;其二,网络资料要用,就自己消化后用自己的话重写,并标注出处;其三,别迷信网上查不到这种经验,抓取范围一直在扩大。
再补一个同学常踩的连锁坑。有人说,那我把网上的内容先洗一遍——找三四篇不同网页,每篇抄几句拼起来,是不是就查不出来?恰恰相反。系统不是只跟单一来源比,它是全文对全文碰撞。你拼来的内容,每一段都能在对应的原始网页里找到连续匹配,结果是重复来源散得到处都是,报告看着密密麻麻,反而更难改。我见过一位同学,综述拼了五个网页,结果重复率比整段抄一篇还高。与其东拼西凑,不如读懂之后自己写。
在paperzx毕业在线网做预检时,我会特别提醒同学留意报告里互联网来源这一栏。它往往是最容易被忽略、却最容易翻车的一块。你以为系统看不见的地方,恰恰是它盯得最紧的地方。
说到底,互联网资源库的存在就是要打破一个幻想:网上公开的东西不等于可以随便用。你在搜索引擎里随手能看到的内容,背后都可能已经躺在系统库里。尊重每一个网页、每一篇帖子的原创劳动,该引用就引用,这既是学术规范,也是最省事的做法。
— — —