很多同学对查重的印象还停留在比汉字。但如果你了解最近几年学术不端检测的技术走向,会发现它早就进入了另一个阶段。我给几个理工科、计算机方向的学生做过咨询,他们最关心的不是论文正文重复,而是代码和跨语言问题。
先说深度学习。现在主流系统大量引入预训练语言模型,把每句话转成高维向量,算两段文本在语义空间里的距离。这带来一个直接后果:过去靠换说法能躲过去的改写,现在无处可躲。模型理解语境,你调换语序、插入转折词,它照样把两段话归为一类。这也是为什么降重越来越难——不是系统变苛刻,是它真的开始读懂了。
再讲跨语言检测。这曾经是个灰色地带。你把一篇英文论文机翻成中文塞进自己论文,几年前确实能蒙混过关。现在不行了。跨语言检测技术能对齐不同语言之间的语义,中文句子和英文原句意思一致,哪怕语言完全不同,也能被关联标记。有个留学回来的同学把导师的英文综述翻成中文交作业,初检报告直接提示疑似跨语言相似。这条路,基本被堵死了。
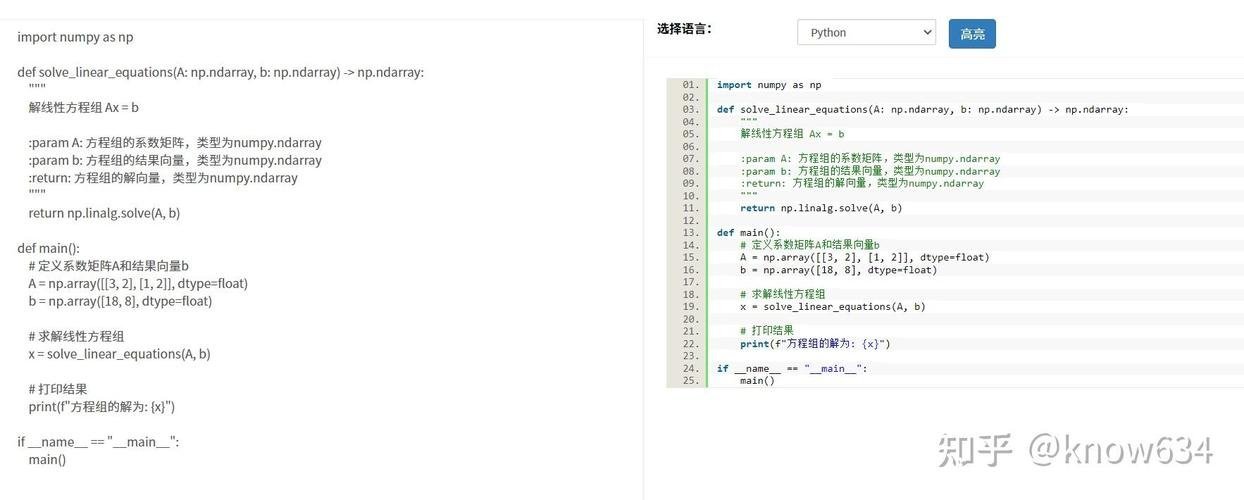
代码相似度分析是另一个前沿领域。计算机、软件工程类专业最怕这个。系统不看你变量名改没改,它把代码解析成语法树,比较控制流和逻辑结构。你把变量a改成x、把函数名换一遍,逻辑骨架没变,相似度照样高。换循环为递归、调换独立语句顺序,这些表观修改在语法树层面几乎不产生影响。
这三块技术合起来,传递的信号很清楚:学术不端检测正在从文字比对走向内容理解。靠技巧绕开的空间越来越小,老老实实写才是正道。
对不同专业的同学,风险点也不一样。文科、社科类同学,重点防跨语言——你读了英文文献,顺手翻成中文写进综述,最容易被关联。计算机类同学,代码查重是大头,别以为课程设计代码没人管,现在很多高校已经把代码相似度纳入检查。理工科做实验的同学,要注意方法部分——实验步骤、仪器参数这类描述,全世界写法高度趋同,天然容易撞,建议结合你自己的具体操作来写,别照抄实验指南。知道自己专业的高发区,提前防,比事后补强。
我在paperzx毕业在线网提醒工科同学的是:代码部分一定要单独用支持代码比对的环境检查,别只查正文;跨语种写作的同学,更要警惕自己无意中翻译了别人的成果。技术一直在跑,别拿几年前的经验打今天的仗。
技术在往前跑,但应对方式万变不离其宗:别想着钻空子,把自己的专业做扎实。文科同学守好引用规范,工科同学盯紧代码和实验描述,跨语种同学管住翻译冲动。各就各位,比什么都强。
— — —